


¿Cómo hacemos nuestras encuestas? Metodología TResearch

Es la pregunta que más nos hacen: ¿cómo hacen la encuesta? Aquí está la respuesta completa.
Esta página explica, en términos técnicos pero claros, cómo TResearch International diseña, levanta, depura, pondera y reporta sus encuestas de opinión y de preferencias electorales, y cómo usamos los modelos sintéticos con inteligencia artificial. Está alineada al Anexo 3 del Reglamento de Elecciones del INE y a las guías internacionales de ESOMAR, AAPOR y WAPOR.
Los datos de cada estudio (ámbito, fechas, entrevistas, margen de error, no respuesta y patrocinio) están en la nota metodológica propia de cada reporte, a la que se llega con su código QR.
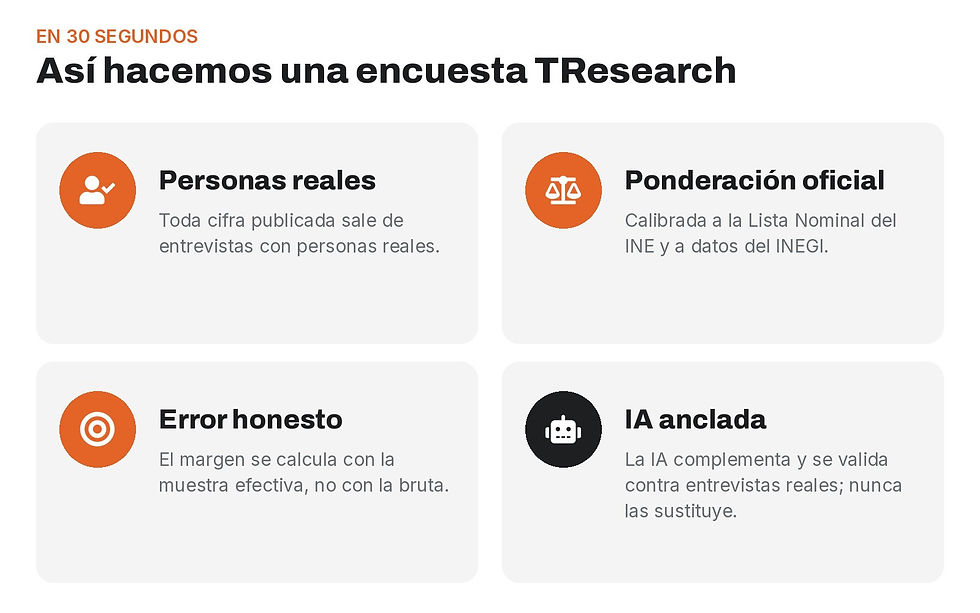

Entrevistas reales, ponderadas con datos oficiales y reportadas con total transparencia.
Medimos la opinión pública con cuestionarios en línea, controlados por cuotas y calibrados con la Lista Nominal del INE y el INEGI. La inteligencia artificial la usamos como herramienta de análisis y de estimación complementaria, siempre anclada en entrevistas reales y nunca como sustituto de una persona.
Desde 2017 hemos levantado más de 2,000 estudios en más de seis países de América Latina. Esa experiencia es la base de cada decisión metodológica que se describe aquí.

Cuestionario en el celular, sin entrevistador
La persona responde un cuestionario autoaplicado en su teléfono. El reclutamiento se hace con anuncios segmentados en las plataformas de Meta (Facebook, Instagram y Messenger). Sin entrevistador no hay presión social para responder «lo correcto», lo que reduce el sesgo de deseabilidad en temas sensibles.
Cuotas, no un enlace abierto
El universo se divide en celdas que cruzan sexo, grupo de edad (18-29, 30-49 y 50 años y más) y, según el estudio, región o zona. Cada celda tiene su propio anuncio y su propio enlace; su meta es proporcional a su peso en la Lista Nominal del INE. Cuando una celda se llena, su anuncio se apaga. Durante el levantamiento vigilamos además la escolaridad, porque el mundo digital sobrerrepresenta a quienes tienen estudios universitarios.

Cómo redactamos las preguntas
Una pregunta por pantalla, en mayúsculas y con pocas opciones.
Enunciados balanceados entre los dos polos: «¿aprueba o desaprueba?».
Un solo concepto por pregunta; en temas polémicos, frases enfrentadas.
Orden de embudo: de lo espontáneo a lo asistido; del conocimiento a la opinión, la aprobación y la preferencia.
Siempre la opción «NO SABE»; nombres en rotación; boleta en el orden oficial.

En estudios electorales la población objetivo es la ciudadanía de 18 años o más con credencial para votar vigente, residente en el ámbito del estudio. Al inicio del cuestionario se verifican edad, credencial y lugar de residencia; quien no cumple, no continúa.
Lo que declaramos siempre: una encuesta en línea sólo alcanza a quienes usan internet y redes sociales. Para reducir ese sesgo calibramos con datos oficiales, lo que corrige sexo, edad, región y escolaridad, pero no necesariamente otras características de quienes no están conectados.

Antes de ponderar, cada cuestionario pasa por reglas automáticas de depuración. Se excluyen:
Personas que no cumplen los filtros de elegibilidad.
Respuestas duplicadas del mismo dispositivo o con la misma huella técnica (cookie, IP y navegador).
Cuestionarios contestados en menos del 40% del tiempo mediano.
Fallas en la pregunta de verificación de atención.
La misma respuesta en toda una batería de preguntas.
Incongruencias, como una edad incompatible con haber votado en la elección anterior.
Conexiones desde fuera del país o con ubicación inconsistente con el ámbito.
Cada reporte informa cuántos casos se excluyeron y por qué.

Ninguna cifra que publicamos es un simple conteo de respuestas. Cada entrevista recibe un peso para representar a su parte de la población:
1. Peso base. Meta de la celda entre entrevistas logradas en ella.
2. Calibración por raking. Ajuste proporcional iterativo que iguala la muestra con la Lista Nominal del INE (sexo × edad), con el INEGI (escolaridad y tamaño de localidad) y con el voto presidencial 2024, hasta una diferencia menor a 0.1 puntos.
3. Recorte. Ningún peso supera 5 veces ni baja de 0.2 veces la mediana.
4. Efecto de ponderación. Recortamos pesos extremos (rango final 0.4 a 3.0) y validamos contra datos oficiales que no se usaron para ponderar.

Si se usa el voto recordado de la elección anterior como variable de calibración, se declara y se publica también la estimación sin ella. En estudios publicables no calibramos con resultados de encuestas de otras casas.

El margen de error se calcula como muestreo aleatorio simple sobre el número de entrevistas reales válidas. Al 95% de confianza:
e = 100 · 1.96 · √( 0.25 ⁄ n )
Nuestro diseño estándar es de 1,000 entrevistas reales válidas: margen de ±3.1 puntos para el total. Por subgrupo: hombres ±4.5, mujeres ±4.3, 18 a 29 años ±6.1, 30 a 49 ±5.0 y 50 o más ±5.2. Subgrupos con menos de 100 entrevistas no se publican.
Dos opciones están en empate estadístico cuando su diferencia es menor a 1.96 veces el error estándar de la diferencia. No basta con ver si los intervalos se tocan.

Lo que el margen no cubre: la muestra no es probabilística; el margen supone que, una vez calibrada, se comporta como aleatoria. No incluye errores de cobertura, redacción u orden de preguntas. Por eso no publicamos subgrupos con menos de 100 entrevistas.

En cada pregunta publicada reportamos por separado a quienes no saben, prefieren no responder, no eligen ninguna opción o anularían su voto, y a quienes no piensan votar. Esas respuestas no se imputan. La votación efectiva (sólo entre quienes definen su voto) se rotula como estimación y lleva su propio intervalo.
Medimos el embudo completo del levantamiento en línea: personas alcanzadas por el anuncio, ingresos al cuestionario, elegibles, completas y válidas. Con él reportamos las dos tasas que pide el INE: contactos no exitosos sobre intentos, y negativas o abandonos sobre contactos.

Además de la encuesta tradicional, en TResearch desarrollamos un motor híbrido que combina tres fuentes:
Datos previos y oficiales: Lista Nominal, censos del INEGI, resultados electorales y series propias.
Trabajo de campo real: entrevistas con personas reales, base de toda inferencia.
Componente sintético: respuestas modeladas con IA a partir del perfil de cada persona entrevistada.

Por qué no basta con la IA sola
Un modelo de lenguaje puede imitar a un perfil de votante, pero tiende a exagerar estereotipos, a desconocer lo reciente y a casi nunca contestar «no sé». En septiembre de 2026, el Pew Research Center comparó respuestas generadas por IA con las de su panel probabilístico y encontró diferencias promedio de 12 puntos. Nuestras propias pruebas llegaron a la misma conclusión: la IA sola se equivoca demasiado.
Lo que hace distinto al modelo híbrido
Un modelo estadístico entrenado con las respuestas reales del estudio y de una encuesta ancla reciente corrige lo que propone la IA. En nuestras validaciones internas, anclar la IA en campo real redujo el error en más de dos terceras partes respecto de la IA sola.
Nivel 1 · Encuesta: sólo entrevistas reales ponderadas. Es lo que se publica como preferencia electoral.
Nivel 2 · Estimación con modelo: real + IA; cada cifra lleva ◆ y su propio intervalo, que incluye el error del modelo.
Nivel 3 · Simulación: sólo IA; herramienta interna para planear y probar cuestionarios. No se publica.

Reglas que no se negocian: una respuesta sintética nunca cuenta como entrevista ni entra al margen de error, y nunca se usa para estimar intención de voto, preferencias por partidos o candidaturas, ni aprobación de autoridades sujetas a elección.


INE: los 12 puntos de los criterios científicos del Anexo 3 del Reglamento de Elecciones.
ESOMAR/WAPOR: Guía para encuestas de opinión y encuestas publicadas; preguntas para compradores de muestras en línea; 20 preguntas para compradores de servicios basados en IA.
AAPOR: Código de ética profesional e Iniciativa de Transparencia; definiciones estándar de tasas.
ISO 20252: norma internacional para investigación de mercados, opinión y social.
Nuestras respuestas a las 20 preguntas de ESOMAR sobre IA
Experiencia y propósito. Usamos IA para acortar cuestionarios, estimar subgrupos pequeños y probar instrumentos; documentamos lo que funcionó y lo que no (la IA sola no sirve para medir opinión pública).
Explicabilidad. Un modelo de lenguaje comercial de última generación propone respuestas a partir de perfiles anónimos; un modelo estadístico propio, entrenado con respuestas reales, las calibra. Modelo, versión e instrucciones se registran.
Validación y límites. Cada cifra modelada se valida fuera de muestra contra respuestas reales; si el error medio supera 3 puntos, no se usa. Los límites conocidos (estereotipos, temas nuevos, subgrupos) se declaran.
Supervisión humana y ética. Un analista revisa y firma cada estimación; las reglas de uso (no electoral, siempre declarada con ◆) son fijas y públicas.
Gobierno de datos y privacidad. Al modelo sólo llegan perfiles anónimos, nunca nombres, contactos ni IP. Cumplimos la Ley Federal de Protección de Datos Personales en Posesión de los Particulares; la propiedad de resultados y bases se define por contrato con cada cliente.

Cada reporte de TResearch incluye su ficha técnica y un código QR que lleva a la nota metodológica completa de ese estudio: ámbito, fechas, entrevistas, cuotas, ponderación, margen de error, no respuesta, tasas de rechazo, autoría, patrocinio y costo.

Cuando una encuesta electoral se publica durante un proceso electoral, el estudio completo con su base de datos se entrega al INE o al organismo público local dentro de los cinco días siguientes, y se respeta el periodo de veda.

¿Una encuesta en línea puede ser representativa?
Sí, si se controla con cuotas, se depura, se calibra con datos oficiales y se declara con honestidad lo que no cubre. Eso es lo que hacemos y lo que reportamos en cada ficha técnica.
¿Por qué ponderan los resultados?
Porque ninguna muestra sale perfecta: en línea responden más jóvenes y más universitarios. La ponderación devuelve a cada grupo su peso real en la población.
¿Cuántas entrevistas hacen y por qué?
Nuestro estándar es de 1,000 entrevistas reales válidas en 3 días de campo, con cuotas por sexo y edad sobre la Lista Nominal del INE. Da un margen de ±3.1 puntos al 95% de confianza y permite leer con solidez los principales subgrupos.
¿Qué pasa con la gente que no tiene internet?
No está cubierta por el marco en línea, y lo declaramos. La calibración reduce el sesgo en las variables que se conocen. Cuando un estudio lo requiere, puede complementarse con otros modos de levantamiento.
¿Cómo evitan bots, respuestas falsas o personas que contestan varias veces?
Enlace único por celda, una respuesta por dispositivo, revisión de huella técnica, tiempos mínimos, preguntas de atención y reglas de congruencia. Lo que no pasa los filtros se excluye y se reporta.
¿Qué es una encuesta sintética?
Es una estimación en la que un modelo de inteligencia artificial propone cómo respondería una persona con cierto perfil. En TResearch sólo la usamos combinada con entrevistas reales (modelo híbrido) y siempre declarada.
¿La inteligencia artificial inventa respuestas?
La IA propone respuestas probables a partir del perfil de personas reales, y un modelo estadístico las contrasta con lo que esas personas efectivamente contestaron. Nunca sustituye entrevistas ni se usa para la intención de voto que publicamos.
¿En qué partes del mundo se usan los modelos sintéticos?
Se investigan desde 2023 en universidades de Estados Unidos y Europa (el trabajo pionero «Out of One, Many», publicado en Political Analysis, acuñó el término «muestras de silicio»). Empresas de investigación de mercados de Estados Unidos, Reino Unido y Europa ya los ofrecen; ESOMAR publicó una guía de 20 preguntas para evaluarlos y el Pew Research Center los puso a prueba en 2026. El consenso internacional es el mismo que el nuestro: la IA sola no reemplaza a las personas; anclada en datos reales y bien validada, sí agrega valor.
¿Es algo novedoso? ¿Quién más lo hace en México?
Sí, es una frontera de la investigación de opinión. Hasta donde sabemos, TResearch es la primera casa encuestadora en México que integra formalmente un modelo híbrido de campo real e inteligencia artificial, validado contra encuestas ancla y con reglas públicas de uso. Siempre hemos buscado estar a la vanguardia en los métodos de investigación de opinión.
¿Qué modelo de IA usan y qué datos le entregan?
Modelos de lenguaje comerciales de última generación. Sólo reciben perfiles anónimos (sexo, edad, región, escolaridad y respuestas cerradas), nunca nombres, teléfonos, correos ni direcciones IP. Modelo, versión, fecha y parámetros se registran en cada estudio.
¿Se puede auditar una encuesta de TResearch?
Sí. Entregamos la base de datos en formato abierto con el peso de cada caso, el cuestionario completo y la nota metodológica; las rutinas de ponderación son reproducibles y cualquier cifra publicada puede recalcularse.
¿Las encuestas pronostican la elección?
No. Una encuesta es una fotografía de la opinión en las fechas del levantamiento. La opinión cambia y la participación el día de la elección también.
¿Por qué distintas encuestas dan resultados distintos?
Por diferencias de método, fechas, redacción de las preguntas, tratamiento de la no respuesta y ponderación, además del propio margen de error. Por eso publicamos todos esos detalles: para que cualquiera pueda comparar.
¿Quién es dueño de los datos y los resultados?
Lo define el contrato con cada cliente. Los datos personales de quienes responden se protegen conforme a la ley y nunca se entregan; las bases se entregan anonimizadas.
¿Dónde veo la metodología de un estudio específico?
En el código QR o el enlace de la ficha técnica de ese reporte.
Descargas y referencias
Los resultados oficiales de las elecciones son exclusivamente los que dan a conocer el Instituto Nacional Electoral y los organismos públicos locales. TResearch International · TRESEARCH GLOBAL, S. de R.L. de C.V. · Aguascalientes, México.


Comentarios